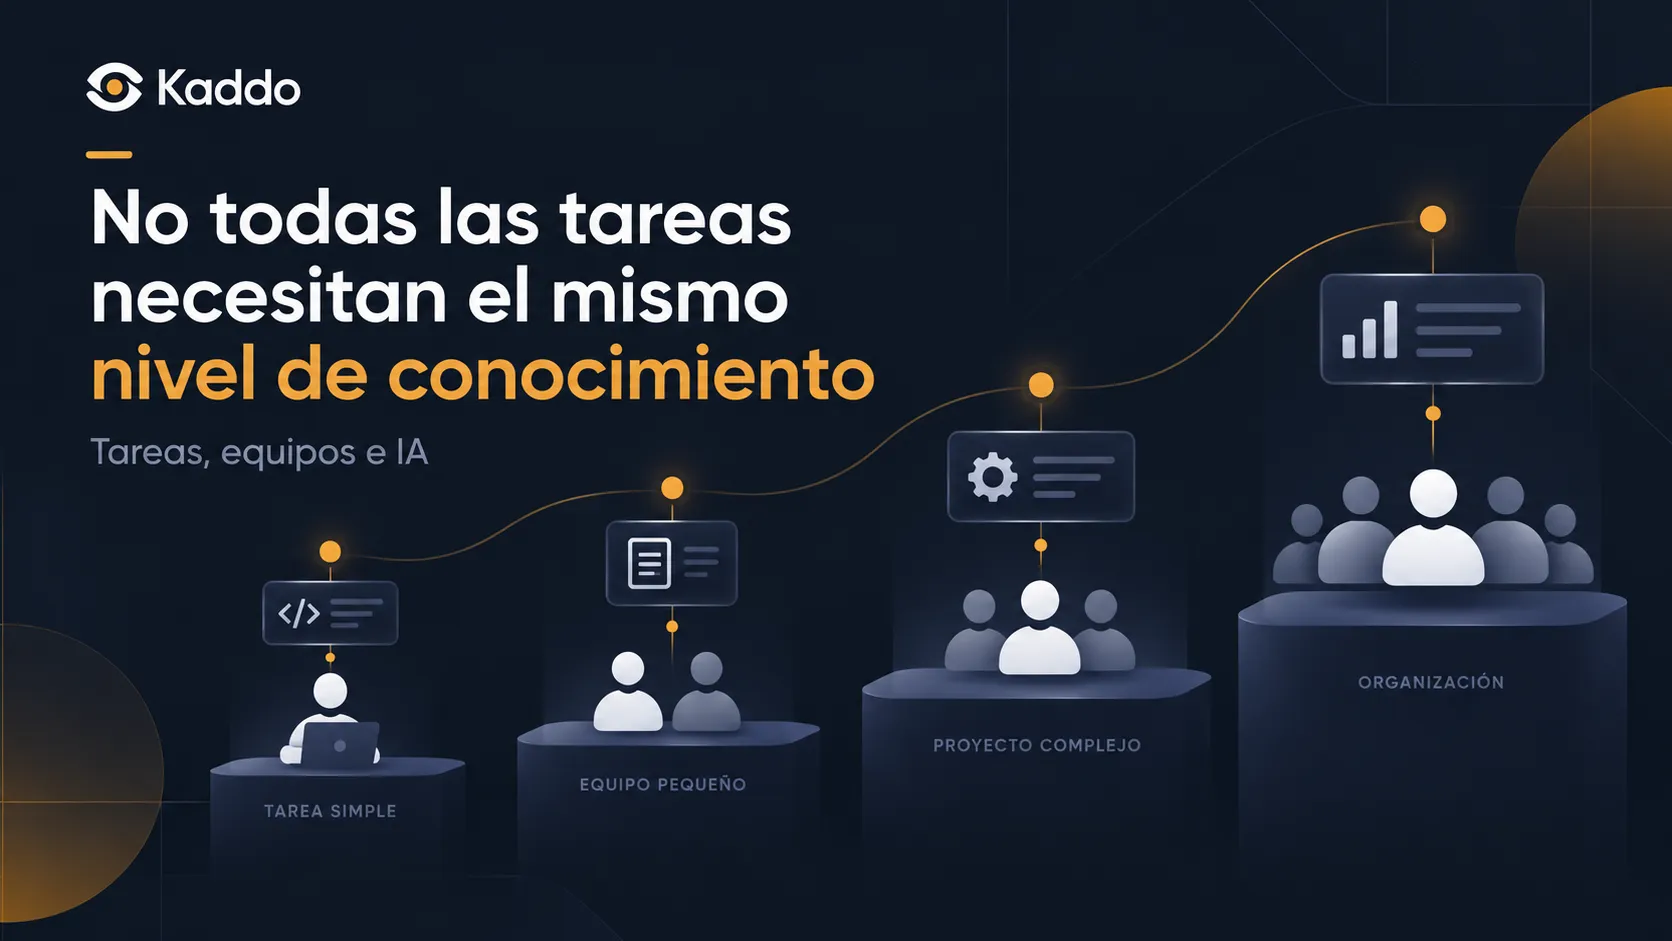
Para los agentes no todas las tareas necesitan el mismo conocimiento
El conocimiento que necesita un agente de IA debería crecer con el alcance de la tarea. El reto no es darle toda la información posible, sino la información correcta.
Publicado originalmente en AWS Builder Center. Primer artículo de la serie Knowledge Driven Development (KDD).
Cuando hablamos de desarrollo asistido por IA, solemos tratar el contexto como si fuera una condición binaria: el modelo tiene contexto o no lo tiene. En la práctica, el problema es bastante más matizado.
Cambiar el texto de un botón no requiere el mismo nivel de conocimiento que modificar un flujo de registro completo. Tampoco es igual trabajar en un proyecto pequeño, donde una sola persona entiende casi todo el sistema, que hacerlo en una organización con varios equipos, dominios y repositorios.
Por eso, una de las ideas que considero más útiles al trabajar con IA es esta: el conocimiento que necesita un agente debería crecer en función del alcance de la tarea que va a resolver. El reto no está en darle toda la información posible, sino en darle la información correcta.
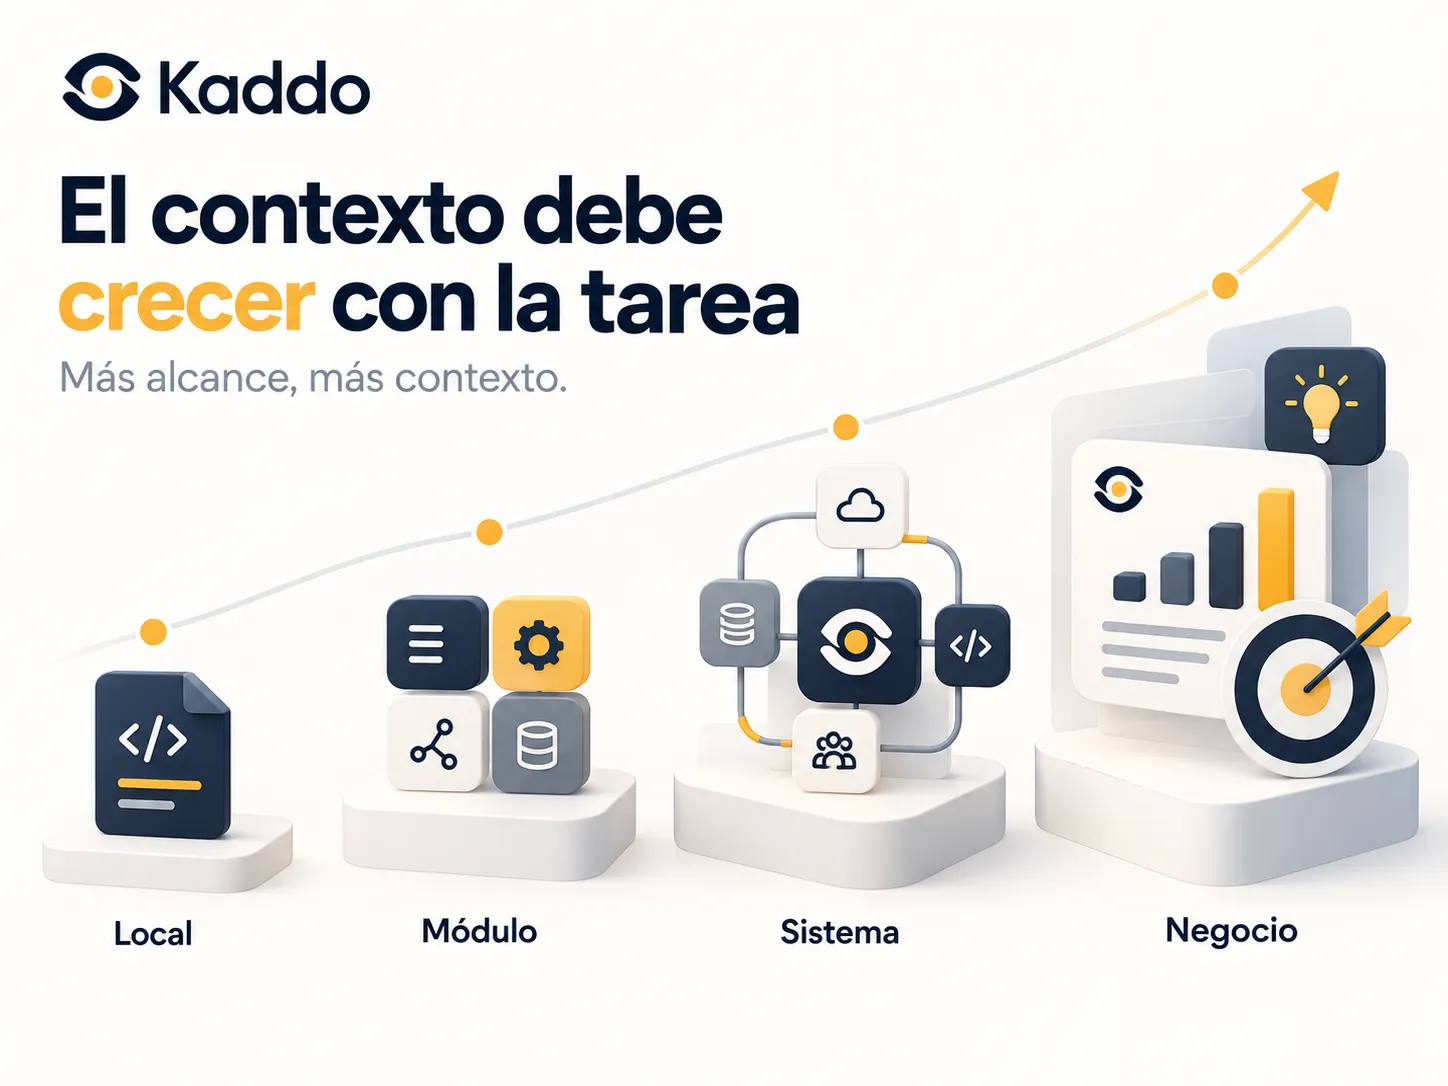
El contexto debe crecer con la tarea
Pensemos en un ejemplo sencillo. Si queremos cambiar el texto de un botón de “Comprar” a “Agregar al carrito”, probablemente sea suficiente con conocer el componente donde está ese botón, las convenciones del frontend y, quizá, la forma en que el proyecto maneja la internacionalización.
No necesitamos explicar toda la arquitectura del sistema ni cómo funciona el proceso de pago, pero si la tarea cambia y ahora queremos conservar el carrito entre sesiones, el contexto necesario aumenta. Ya no basta con conocer el componente visual. Hay que entender cómo se maneja el estado, dónde se persiste la información, cómo se identifica al usuario y qué ocurre cuando todavía no está autenticado.
Si después queremos permitir compras como invitado, el alcance puede crecer todavía más y afectar autenticación, checkout, órdenes, pagos o incluso varios repositorios. El mismo producto puede requerir niveles de conocimiento muy distintos dependiendo de lo que queramos cambiar.
Una forma práctica de pensarlo es dividir ese conocimiento en cuatro niveles (relacionado con los Knowledge Levels de Kaddo):
| Nivel | Qué necesita entender | Ejemplo |
|---|---|---|
| Local | Archivo, componente, función y convenciones cercanas | Cambiar una validación o un texto |
| Módulo | Responsabilidad del módulo, dependencias y reglas del dominio | Agregar una nueva operación al carrito |
| Sistema | Interacciones entre módulos, servicios y repositorios | Modificar el flujo de registro |
| Negocio | Objetivo, reglas, restricciones y resultado esperado | Cambiar el modelo de onboarding de usuarios |
El problema aparece cuando tratamos una tarea como local cuando en realidad tiene impacto sistémico. Por ejemplo, un work item como “habilitar el registro después de la beta” puede parecer un cambio sencillo en backend. Sin embargo, quizá el frontend todavía muestra una pantalla invitando a los usuarios a registrarse en la beta, existe un feature flag o hay una regla adicional en otro repositorio.
El agente podría implementar correctamente el cambio técnico y aun así dejar incompleto el objetivo de producto. En ese caso, el problema no sería necesariamente la capacidad del modelo, sino haber trabajado con un nivel de conocimiento menor al alcance real de la tarea.
El tamaño del equipo también cambia la forma de gestionar conocimiento
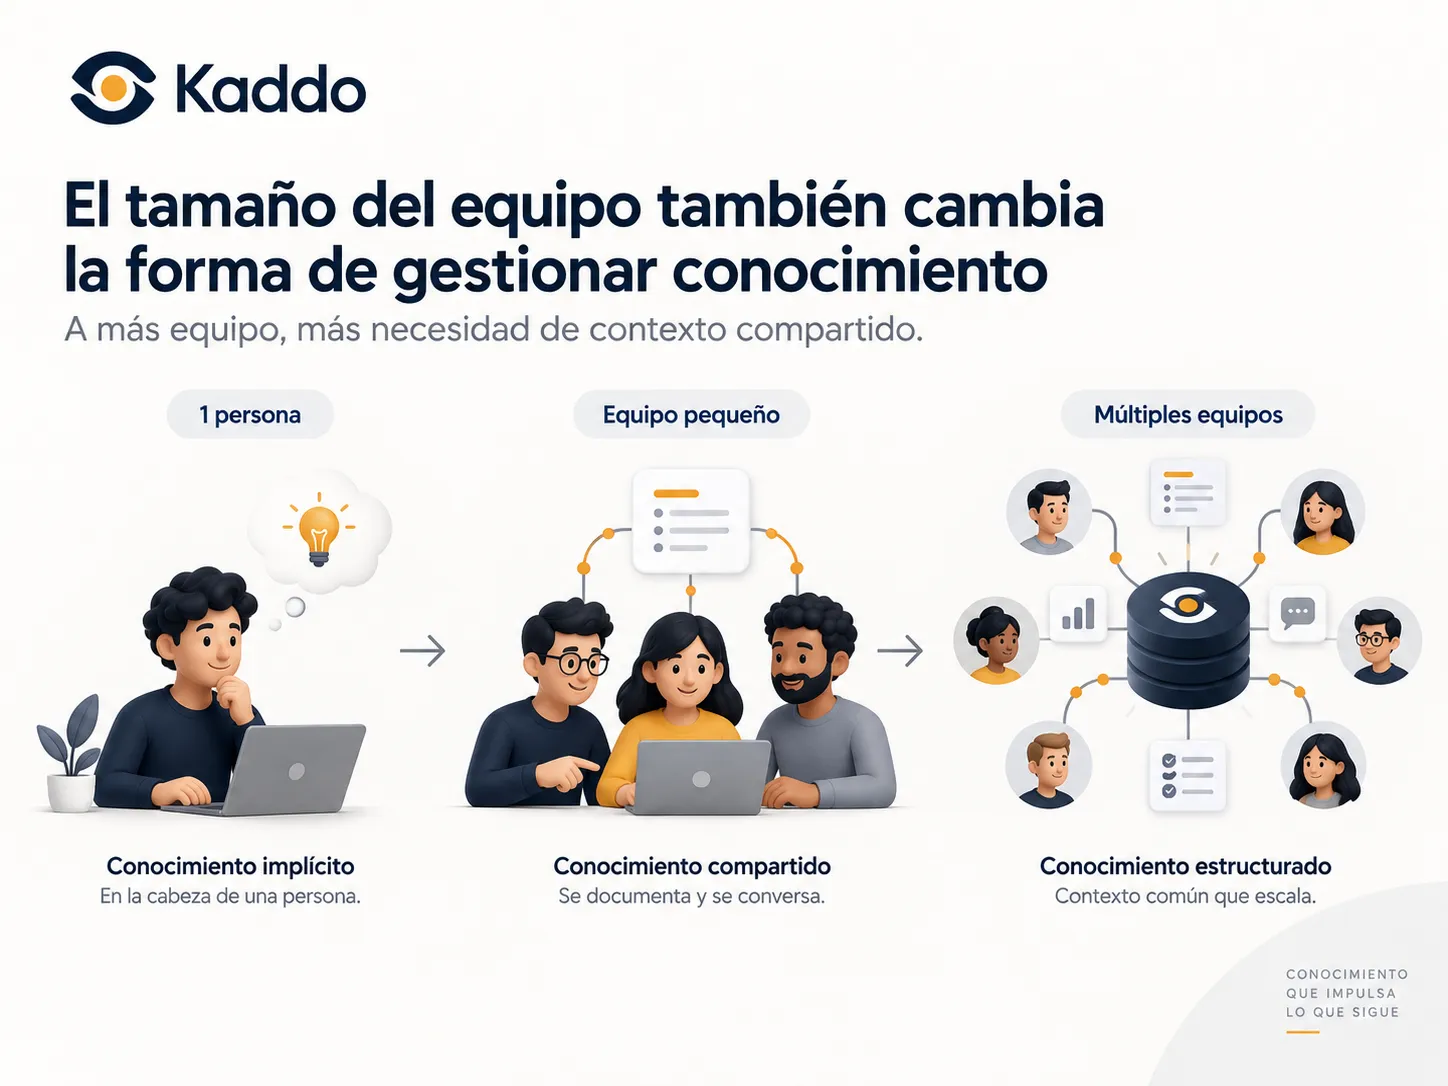
La misma lógica aplica cuando crecen los equipos. En un proyecto mantenido por una sola persona, buena parte del conocimiento puede estar implícito. Quien desarrolla recuerda decisiones anteriores, conoce las dependencias y entiende por qué ciertas partes del sistema funcionan de determinada manera.
Cuando el equipo crece, ese modelo empieza a quedarse corto: aparecen personas especializadas en frontend, backend, infraestructura o producto. También empiezan a existir ownership por módulos, distintos repositorios y decisiones que no todos conocen.
Un desarrollador puede entender perfectamente su servicio y no saber qué ocurre antes o después de él dentro del flujo completo; la IA enfrenta exactamente el mismo problema. Un agente trabajando dentro del repositorio de pagos puede entender muy bien ese código, pero eso no significa que conozca cómo checkout genera una orden o cómo otro servicio interpreta el resultado del pago.
A medida que aumenta el tamaño del equipo, el conocimiento necesita pasar de ser principalmente implícito a convertirse en algo compartido y estructurado.
El reto es todavía mayor en proyectos multirepo
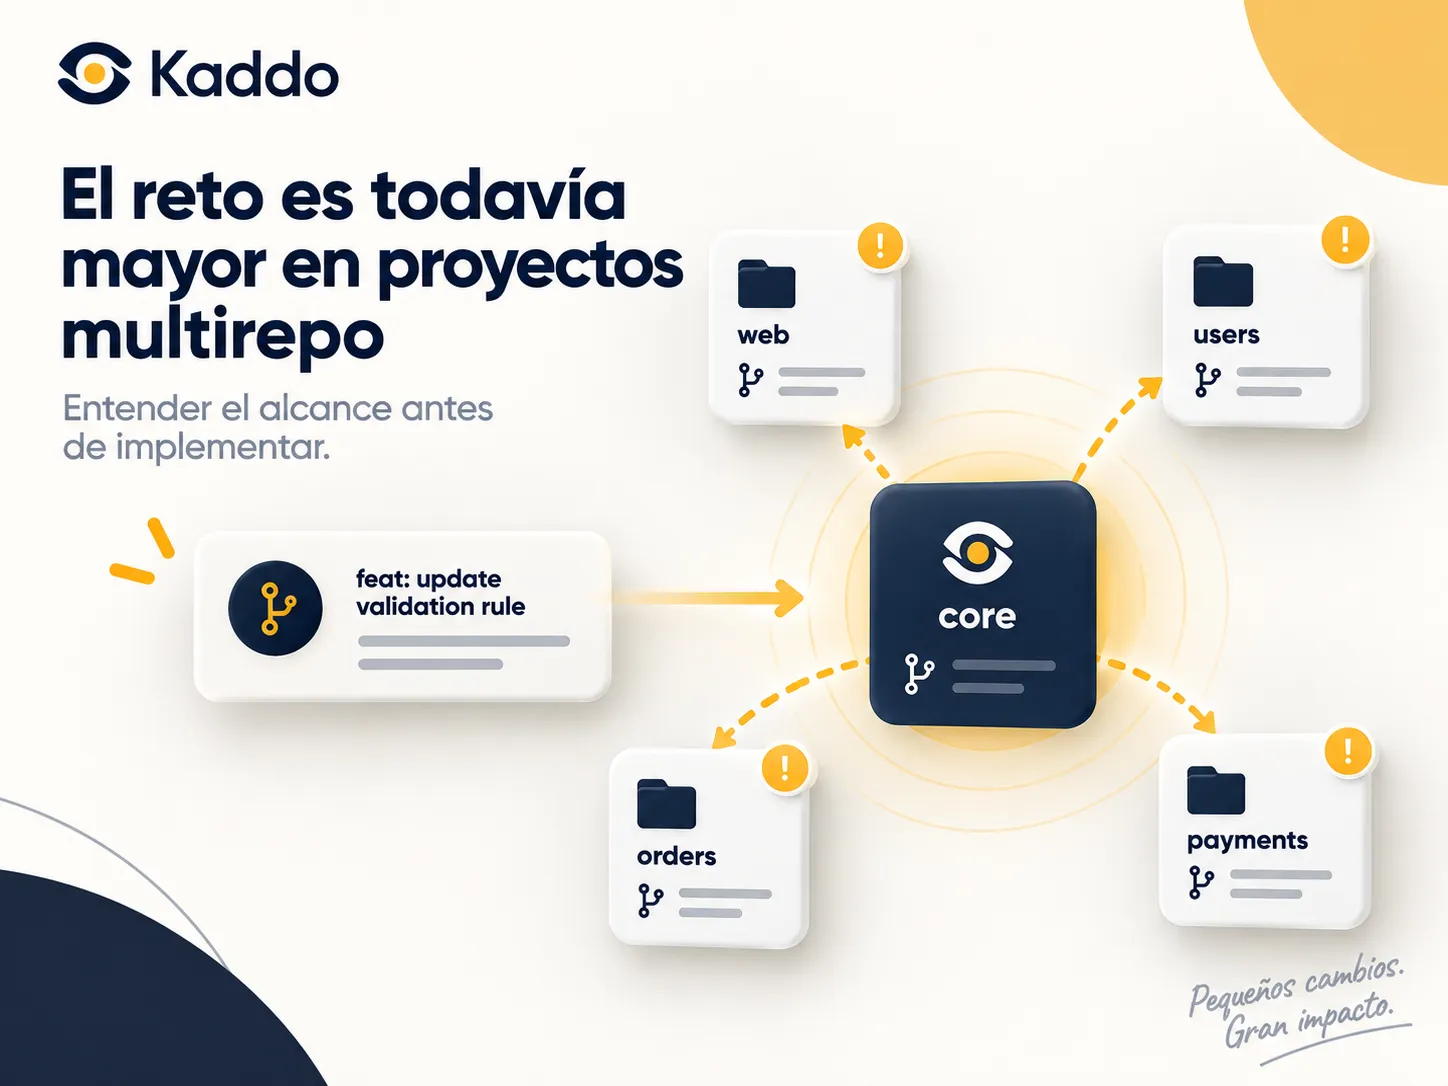
En sistemas distribuidos, esta necesidad se vuelve mucho más evidente. Imaginemos una plataforma con cuatro repositorios: web, users, orders y payments. Ahora aparece un work item que pide permitir compras como invitado. Si un agente analiza únicamente users, puede proponer una solución correcta desde el punto de vista de autenticación. Si trabaja solo en web, quizá resuelva la parte visual. Si entra directamente en orders, probablemente modifique cómo se identifica al comprador.
Cada cambio puede tener sentido dentro de su repositorio y, aun así, no resolver por completo la necesidad. Antes de implementar, necesitamos entender el alcance end-to-end: qué módulos participan, qué responsabilidades tiene cada uno y cuáles probablemente necesiten cambiar. Ese entendimiento debe aparecer antes de entrar al código.
El work item también debe transportar conocimiento
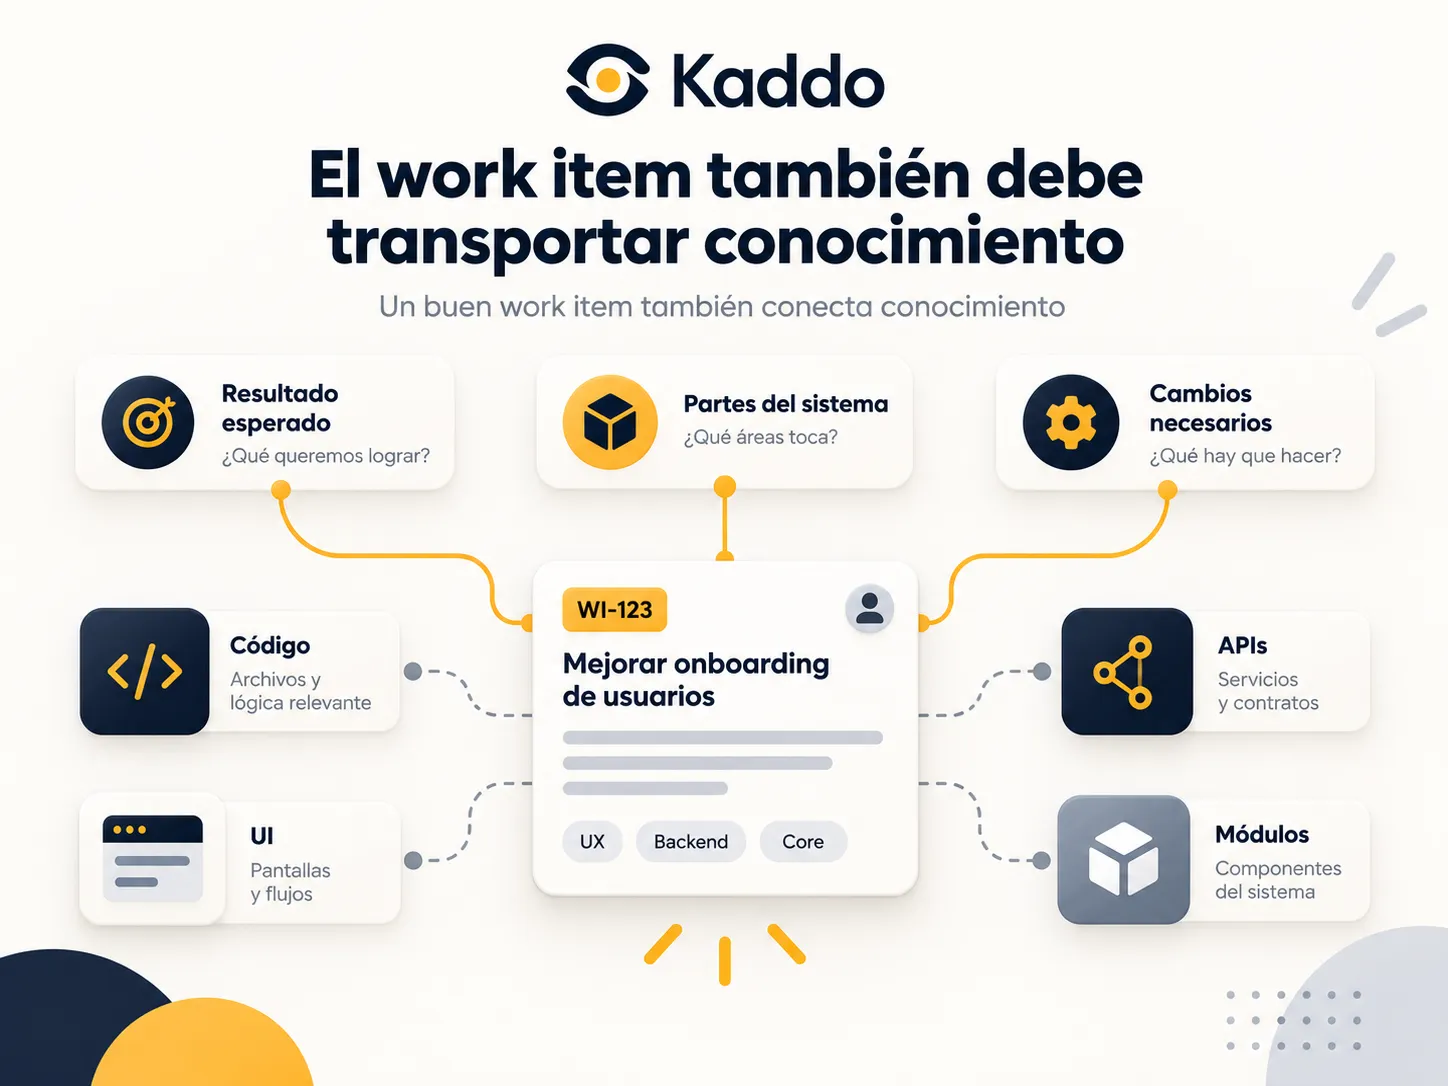
Con desarrollo asistido por IA, un work item deja de ser solamente una descripción de lo que queremos construir. También puede convertirse en el punto donde reunimos el conocimiento necesario para construirlo correctamente.
Un buen refinamiento debería ayudarnos a responder tres cosas: qué resultado queremos lograr, qué partes del sistema participan y qué cambios son realmente necesarios. Solo después de responder esas preguntas tiene sentido bajar al nivel de archivos, APIs, funciones o componentes.
Si empezamos directamente desde el código, corremos el riesgo de encontrar una solución local para un problema que en realidad era sistémico.
Cómo estoy abordando este problema con Kaddo
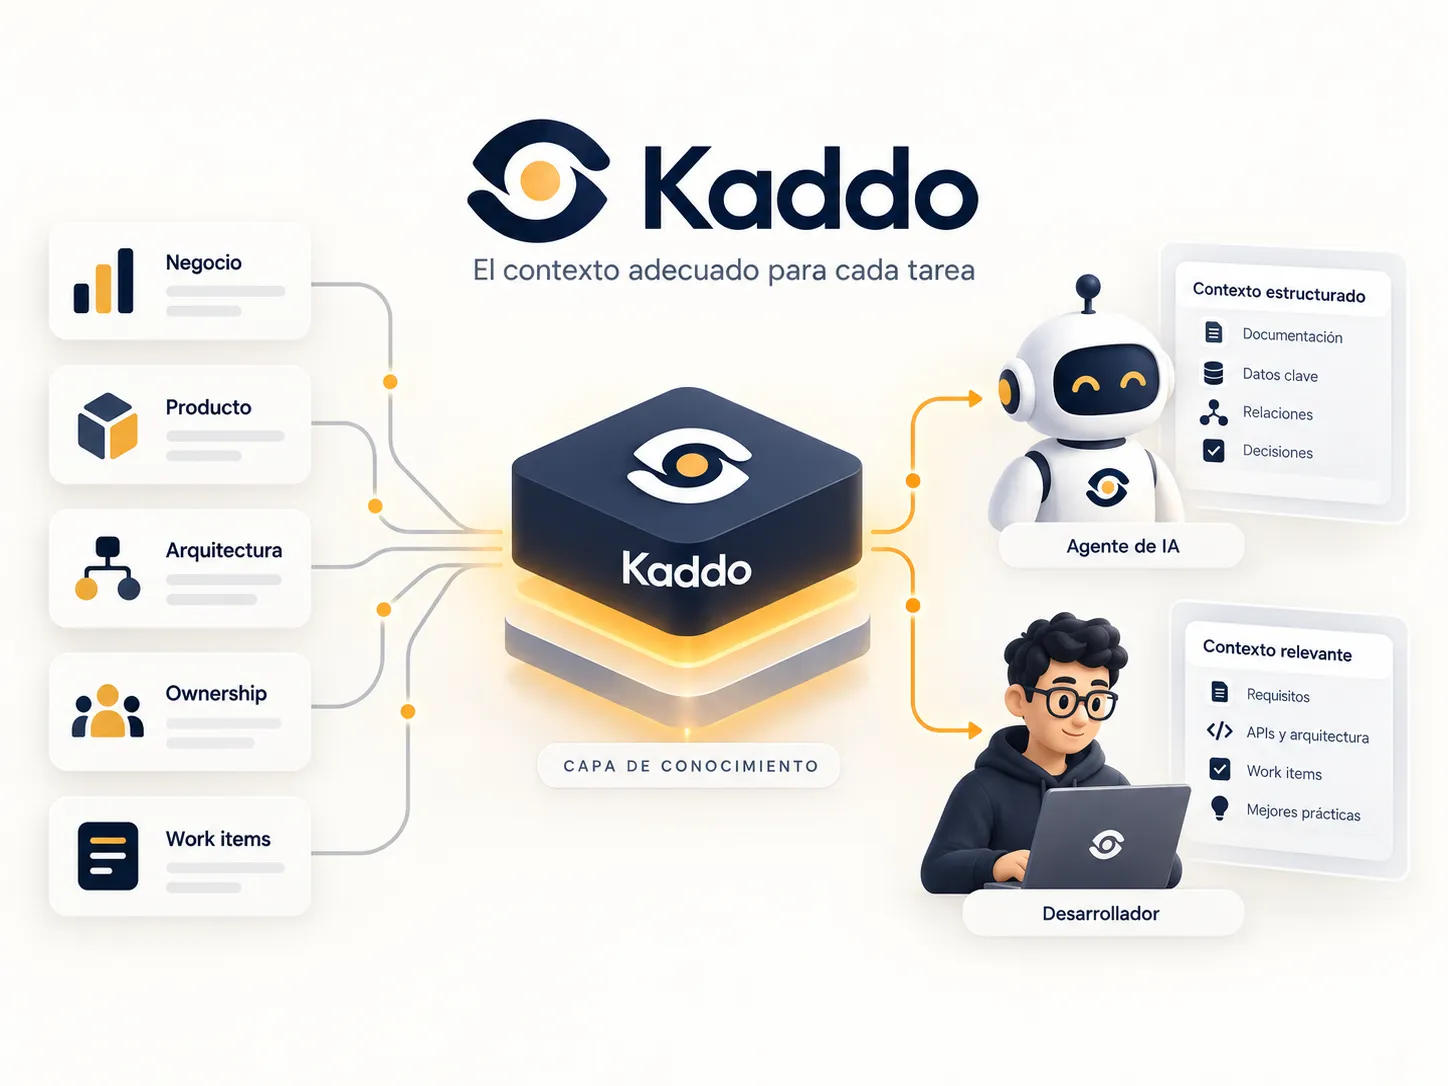
Esta idea ha influido bastante en cómo estoy refinando Kaddo. El objetivo no es darle siempre todo el conocimiento del proyecto a un agente —eso podría introducir ruido y aumentar innecesariamente el contexto—, sino que el agente pueda trabajar con el nivel de conocimiento adecuado para cada tarea.
Un cambio pequeño puede resolverse con contexto del módulo. Un work item que afecta una capacidad completa necesita información adicional sobre arquitectura y producto. En una solución multirepo, primero necesitamos una visión global que permita identificar qué repositorios forman parte del alcance. Por eso Kaddo mantiene conocimiento de negocio, producto, tecnología, delivery, arquitectura y ownership, y busca relacionarlo con los work items que se van refinando.
En proyectos multirepo, además, un repositorio puede actuar como core del conocimiento general, mientras que los demás mantienen el contexto específico de cada módulo. Así, cuando se refina un work item desde el core, es posible evaluar el impacto sobre diferentes partes de la solución antes de comenzar la implementación. La intención es sencilla: entender el alcance antes de construir.
Más contexto no siempre significa mejor contexto
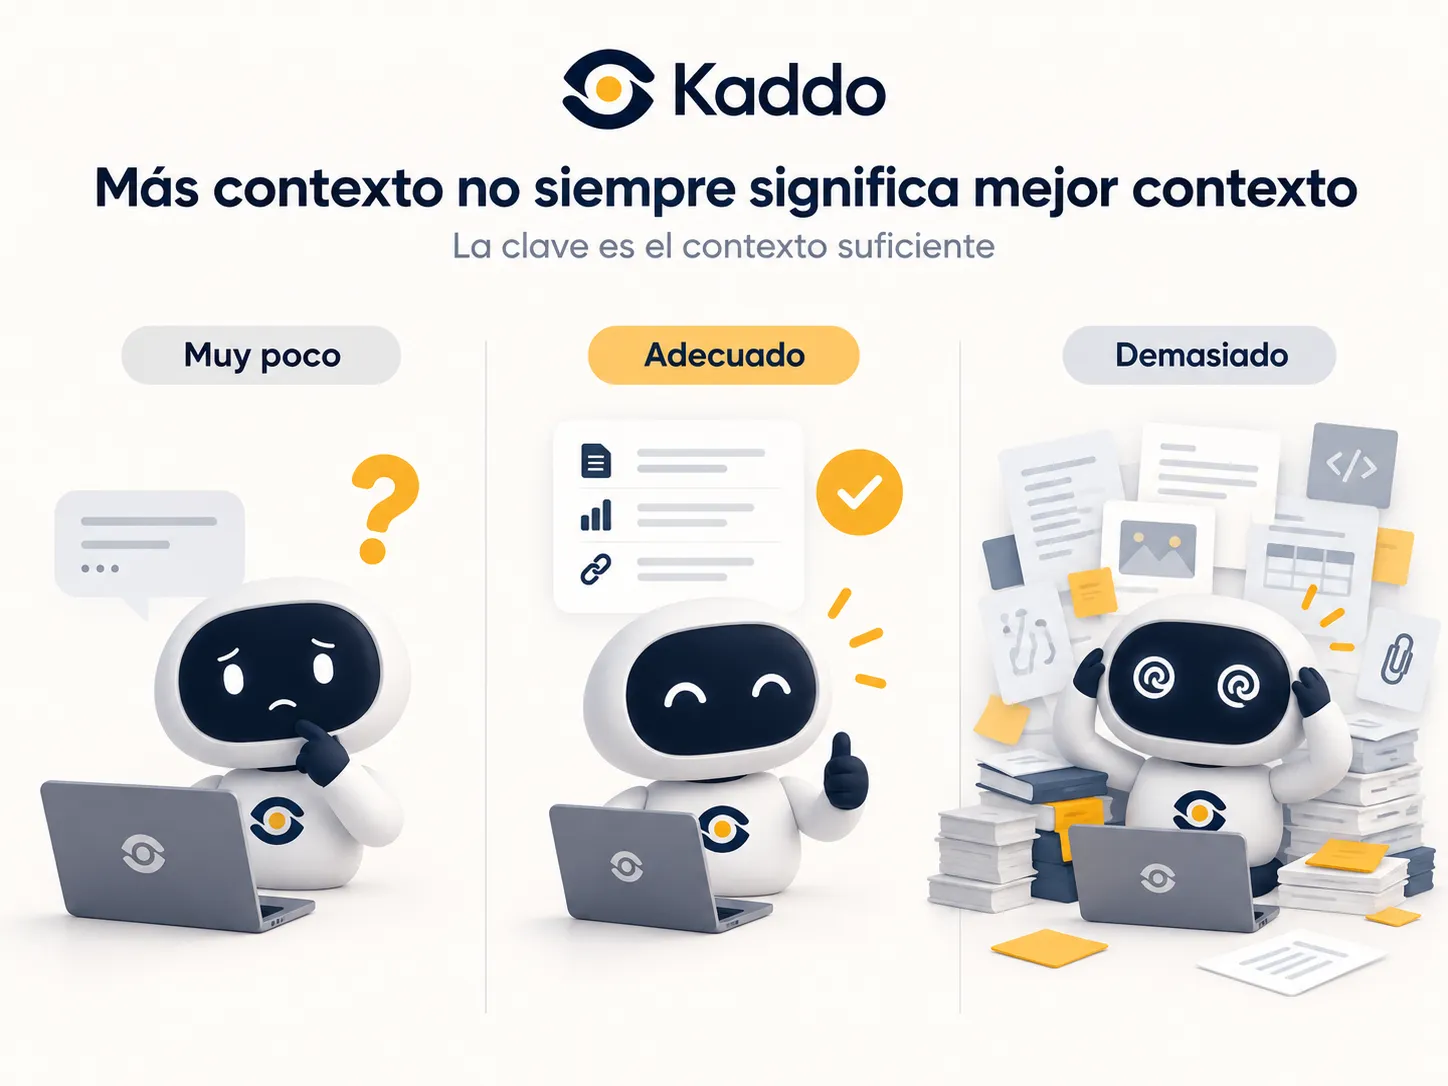
También existe el error contrario: pensar que la solución consiste en entregarle al modelo todo el repositorio, todos los documentos y todas las decisiones disponibles.
Más información no garantiza una mejor respuesta. Un exceso de contexto puede introducir ruido, dificultar la priorización de información y hacer que el agente pierda de vista lo realmente importante para la tarea.
La meta debería ser entregar el conocimiento suficiente para la decisión que se está tomando: una modificación local necesita contexto local, una decisión arquitectónica necesita entender el sistema, una funcionalidad que cambia la experiencia del usuario puede necesitar llegar hasta producto y negocio. El contexto debería crecer de forma proporcional al alcance.
Cuando el equipo crece, la memoria del proyecto también debe hacerlo
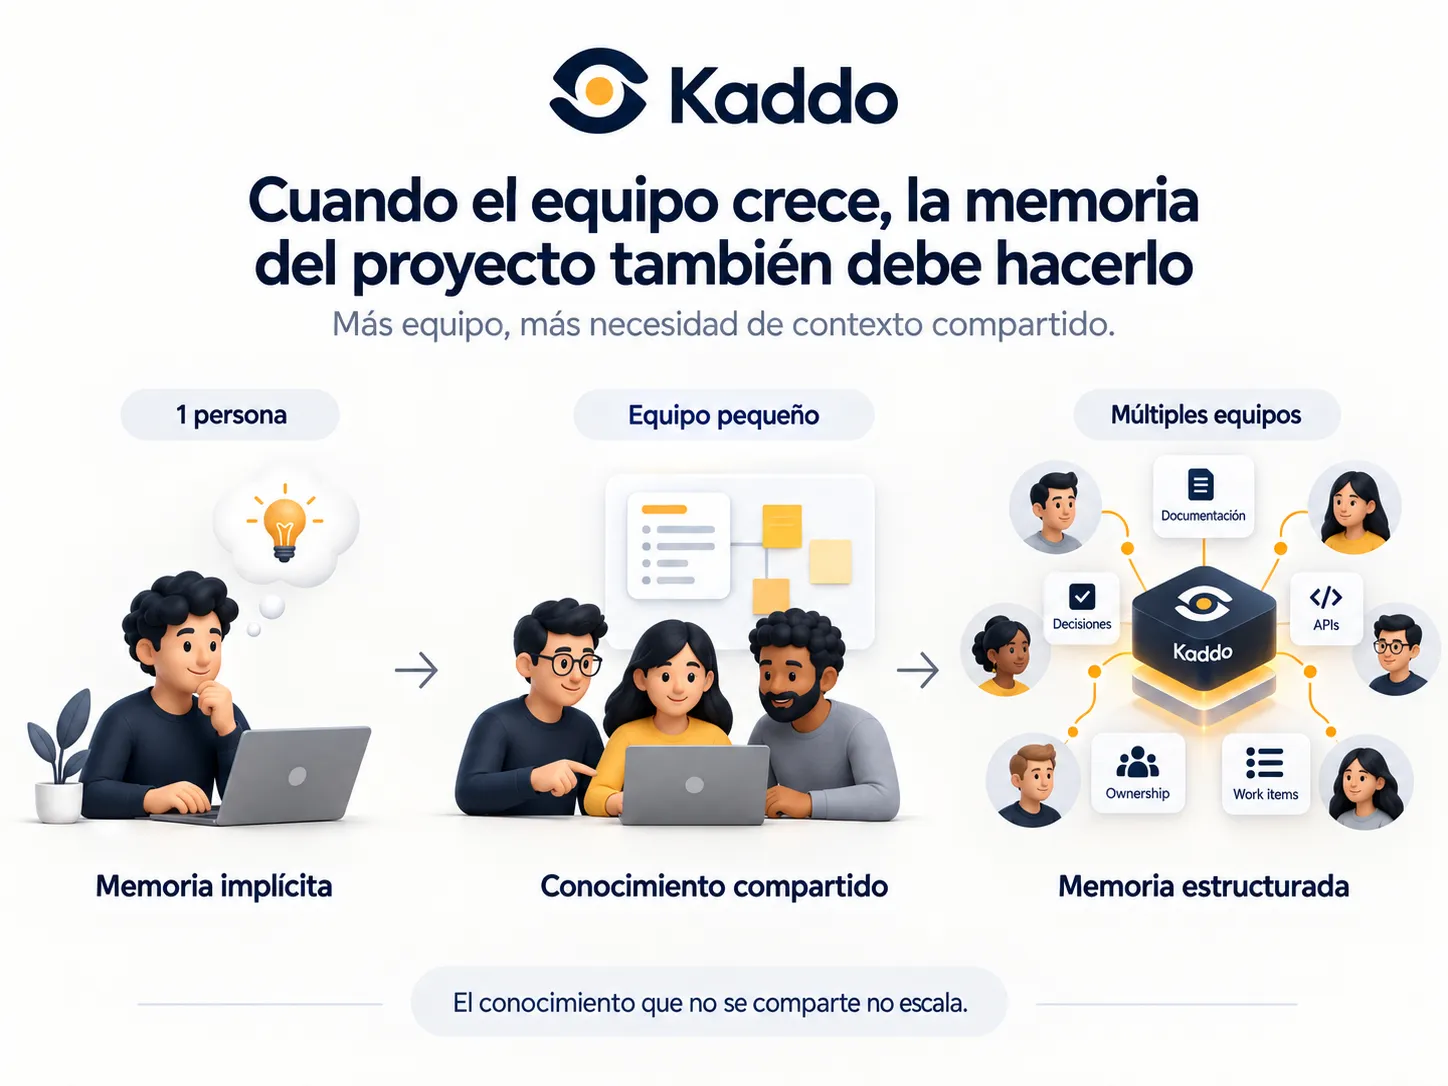
En equipos pequeños, muchas decisiones pueden sobrevivir gracias a conversaciones frecuentes. Sin embargo, cuando aparecen varios equipos, dominios y repositorios, depender exclusivamente de la memoria de las personas deja de escalar. En ese punto necesitamos una memoria compartida del proyecto.
No necesariamente más documentación, sino mejores conexiones entre lo que ya sabemos: qué módulo pertenece a quién, qué decisiones existen, qué riesgos hay, qué capacidades dependen de qué componentes y qué debería conocer alguien antes de modificar una parte determinada del sistema.
Ese conocimiento no solo ayuda a las personas; también se convierte en la base con la que pueden trabajar los agentes de IA. Por eso, en un contexto de desarrollo asistido por IA, el conocimiento empieza a funcionar como parte de la infraestructura del proyecto.
Conclusión
No todas las tareas necesitan el mismo nivel de conocimiento, y tampoco todos los equipos pueden gestionar ese conocimiento de la misma manera. Una modificación pequeña puede resolverse entendiendo unas pocas líneas de código, mientras que una funcionalidad end-to-end puede requerir contexto de negocio, producto, arquitectura y varios repositorios.
A medida que aumenta el alcance de una tarea y el conocimiento se distribuye entre más personas y sistemas, también aumenta la importancia de tener contexto compartido, trazable y cercano al proyecto.
Por eso, antes de preguntarnos qué modelo usar o cómo escribir un mejor prompt, conviene empezar con una pregunta más básica: ¿qué necesita saber la IA para resolver correctamente esta tarea? En desarrollo asistido por IA, muchas veces la calidad de la solución se define antes de escribir una sola línea de código.